GPT-5.6 Luna in GitHub Copilot: Kostenoptimierung, Unteragenten und Kontextmanagement
GPT-5.6 Luna widerlegt die alte Regel, dass kostengünstige Modelle nur für einfache Aufgaben geeignet sind. Mit MAX-Reasoning und 1 Mio. Zeichen Kontext bewältigt es Recherche, Implementierung und die Arbeit von Unteragenten zu einem Bruchteil der Kosten von Spitzenmodellen. Luna ist das neue Schweizer Taschenmesser für die tägliche Entwicklungsarbeit.
Leichtgewichtige Modelle standen früher für Standardlösungen und schnelle Bearbeitungen. Luna eignet sich gut genug für anspruchsvolle Aufgaben und ist günstig genug, um standardmäßig eingesetzt zu werden. Heben Sie sich die „Frontier“-Modelle für die schwierigsten Entscheidungen auf.
GPT-5.6 Luna-Benchmarks: Eine neue Definition für schlanke KI-Modelle
GPT-5.6 Luna ist ein ressourcenschonendes OpenAI-Modell, das in GitHub Copilot verfügbar ist.
Laut Artificial Analysis erreicht Luna einen Wert von 52; damit liegt die Leistung nahe an der von Sonnet 5 und deutlich über der von GPT-5.4 mini. Die gemessenen Kosten pro Benchmark-Aufgabe betragen bei Luna etwa 0,05 US-Dollar gegenüber 1,72 US-Dollar bei Sonnet 5.
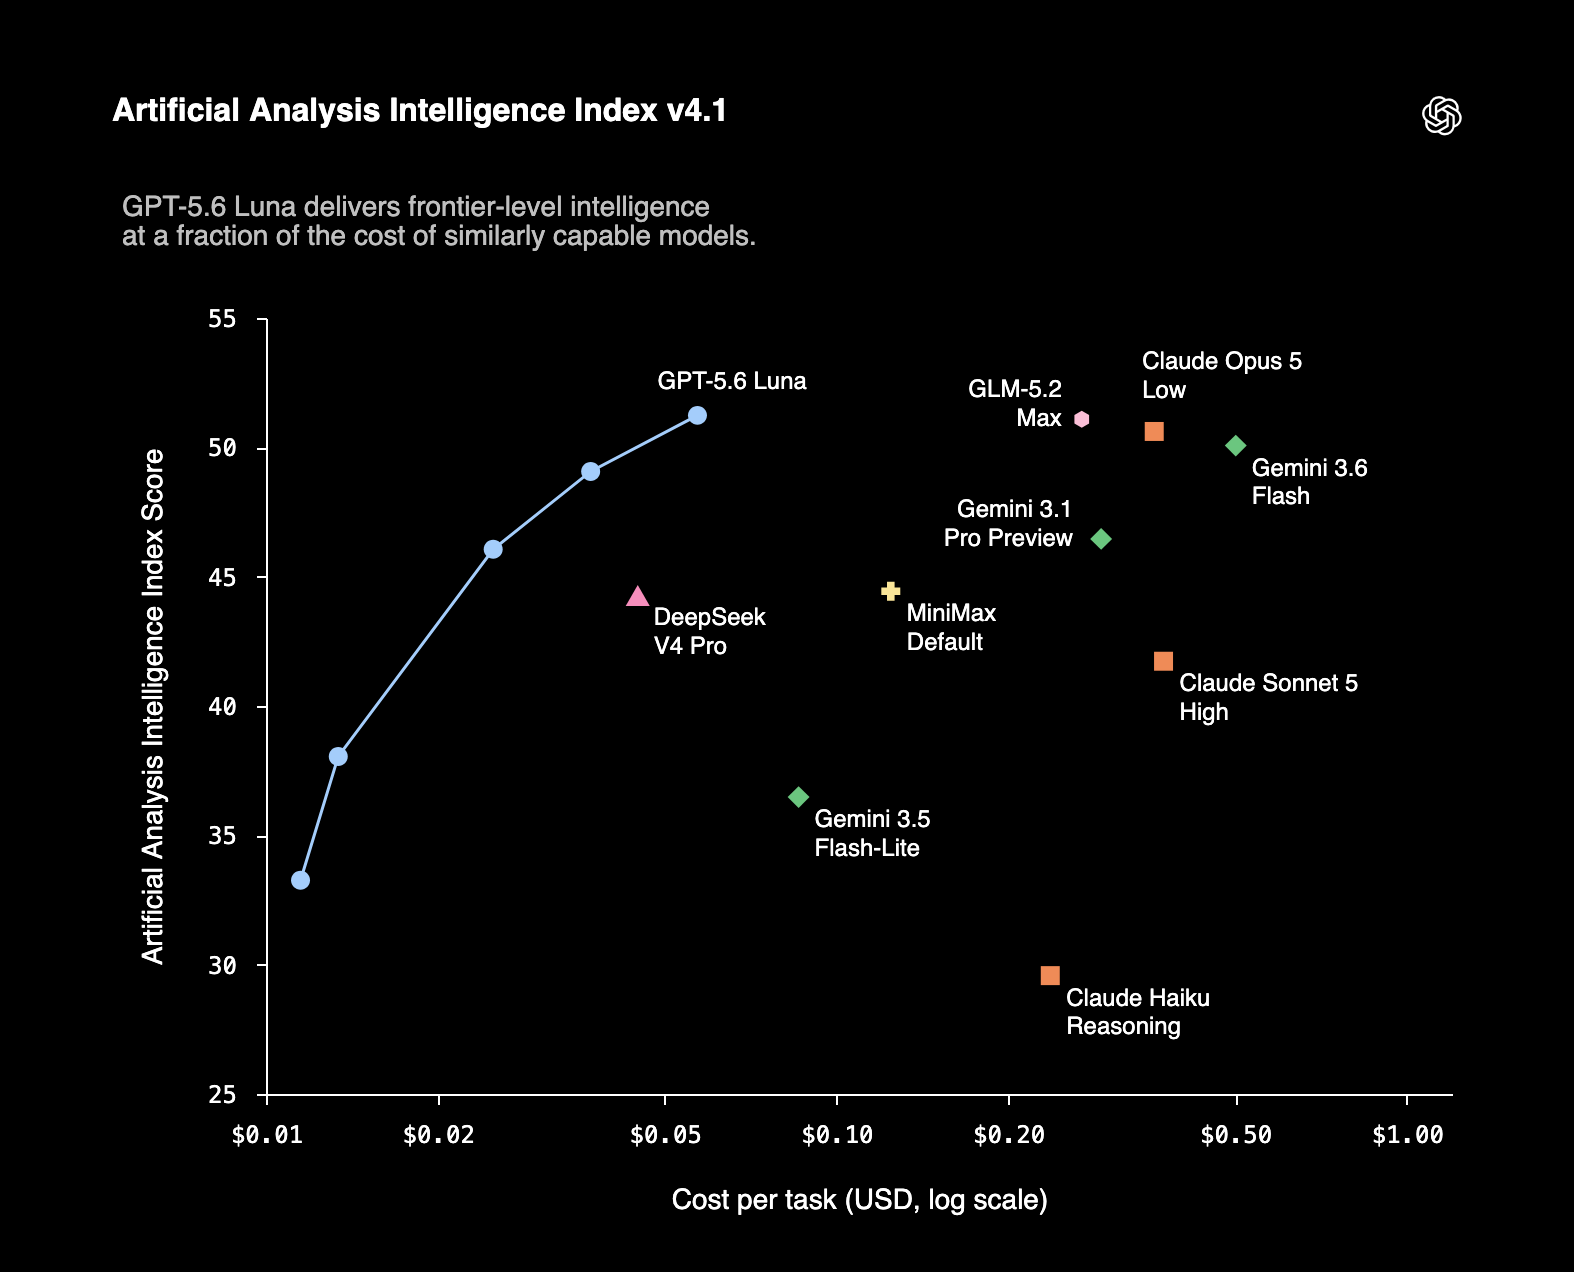
Der Benchmark verwendete Luna mit MAX-Inferenz.
Für die direkte OpenAI-API gelten folgende Standardpreise für GPT-5.6 Luna pro einer Million Token:
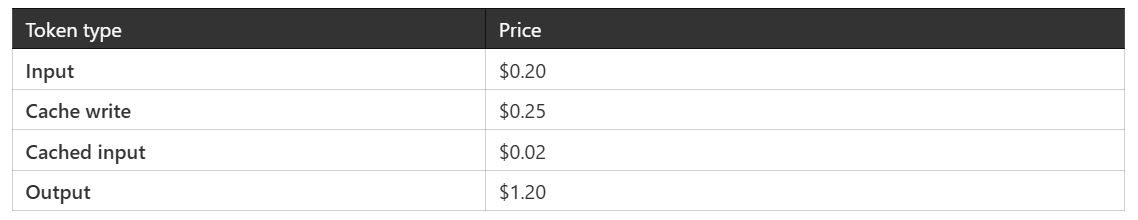
GitHub Copilot verdoppelt die Preise von Luna bei mehr als 200.000 Eingabetoken. Es ist nach wie vor deutlich günstiger als die neuesten Modelle. Ich empfehle, es bei „MAX“ mit Bedacht einzusetzen.
Kontextökonomie: Warum lange GitHub-Copilot-Chats mehr kosten
Das Modell empfängt nicht nur Ihre letzte Nachricht. In jedem Durchlauf können Systemanweisungen, Werkzeugdefinitionen, angehängte Dateien, frühere Nachrichten und Werkzeugausgaben erneut gesendet werden.
Das bedeutet, dass ein Chat mit 100.000 Token, der für fünf weitere Runden genutzt wird, einen Großteil dieser 100.000 Token noch fünf Mal verarbeiten kann. Durch das Zwischenspeichern von Prompts sinken die Kosten für wiederholten Kontext, doch der Chat wächst weiterhin in Richtung seiner Kontextgrenze.
Verwende /compact, wenn sich dieselbe Unterhaltung in die Länge zieht. Eröffne einen neuen Chat, wenn sich das Thema ändert.
Günstige Unteragenten einsetzen, um den Frontier-Kontext zu schützen
Ein „Frontier Parent“-Modell kann gezielte Aufgaben an kostengünstigere Unteragenten delegieren. Zu den geeigneten Aufgaben gehören beispielsweise die Erfassung einer Codebasis, das Sammeln von Dokumentation, der Vergleich von Optionen oder das Ausführen von Tests.
Jeder Unteragent erhält einen sauberen Kontext und gibt nur sein Endergebnis zurück. Seine Suchergebnisse und Werkzeugausgaben gelangen niemals in den ressourcenintensiven Kontext des übergeordneten Agenten.
Überprüfen Sie das Modell, bevor Sie Aufgaben delegieren. Unteragenten übernehmen standardmäßig das übergeordnete Modell, und jeder Unteragent verarbeitet seine eigene Startanfrage. Das versehentliche Ausführen mehrerer Frontier-Unteragenten kann kostspieliger sein, als die Arbeit im übergeordneten Chat zu erledigen.
Bei einem kostengünstigen Modell wickelt der Unteragent seine Aufrufe kostengünstig ab, und der übergeordnete Agent an der Grenze erhält eine kurze Antwort anstelle seitenlanger Zwischenberichte.
Das übergeordnete Modell entscheidet, ob eine Delegierung erfolgen soll, und erstellt die Aufgabe für den Unteragenten. Sie können dies in Ihrer Eingabeanweisung steuern, z. B.: „Verwende GPT-5.6-Luna-Unteragenten für die Online-Recherche.“
Konfigurieren von Copilot-Subagenten in VS Code (Entdecken, Suchen, Implementieren)
GitHub Copilot in VS Code nutzt nun mehrere spezialisierte Worker:
- Entdecken: Schreibgeschützter Subagent, der von „Plan“ zur Erfassung der Codebasis verwendet wird.
- Suche: Experimenteller Subagent, der iterativ in einem isolierten Kontext sucht.
- Implementierung: Der Codierungsschritt des Plans mit einer separaten Modelleinstellung.
Um für diese Arbeit ein anderes Modell zu verwenden:
- Aktivieren Sie „Agent/runSubagent“ in der Auswahl der Chat-Tools.
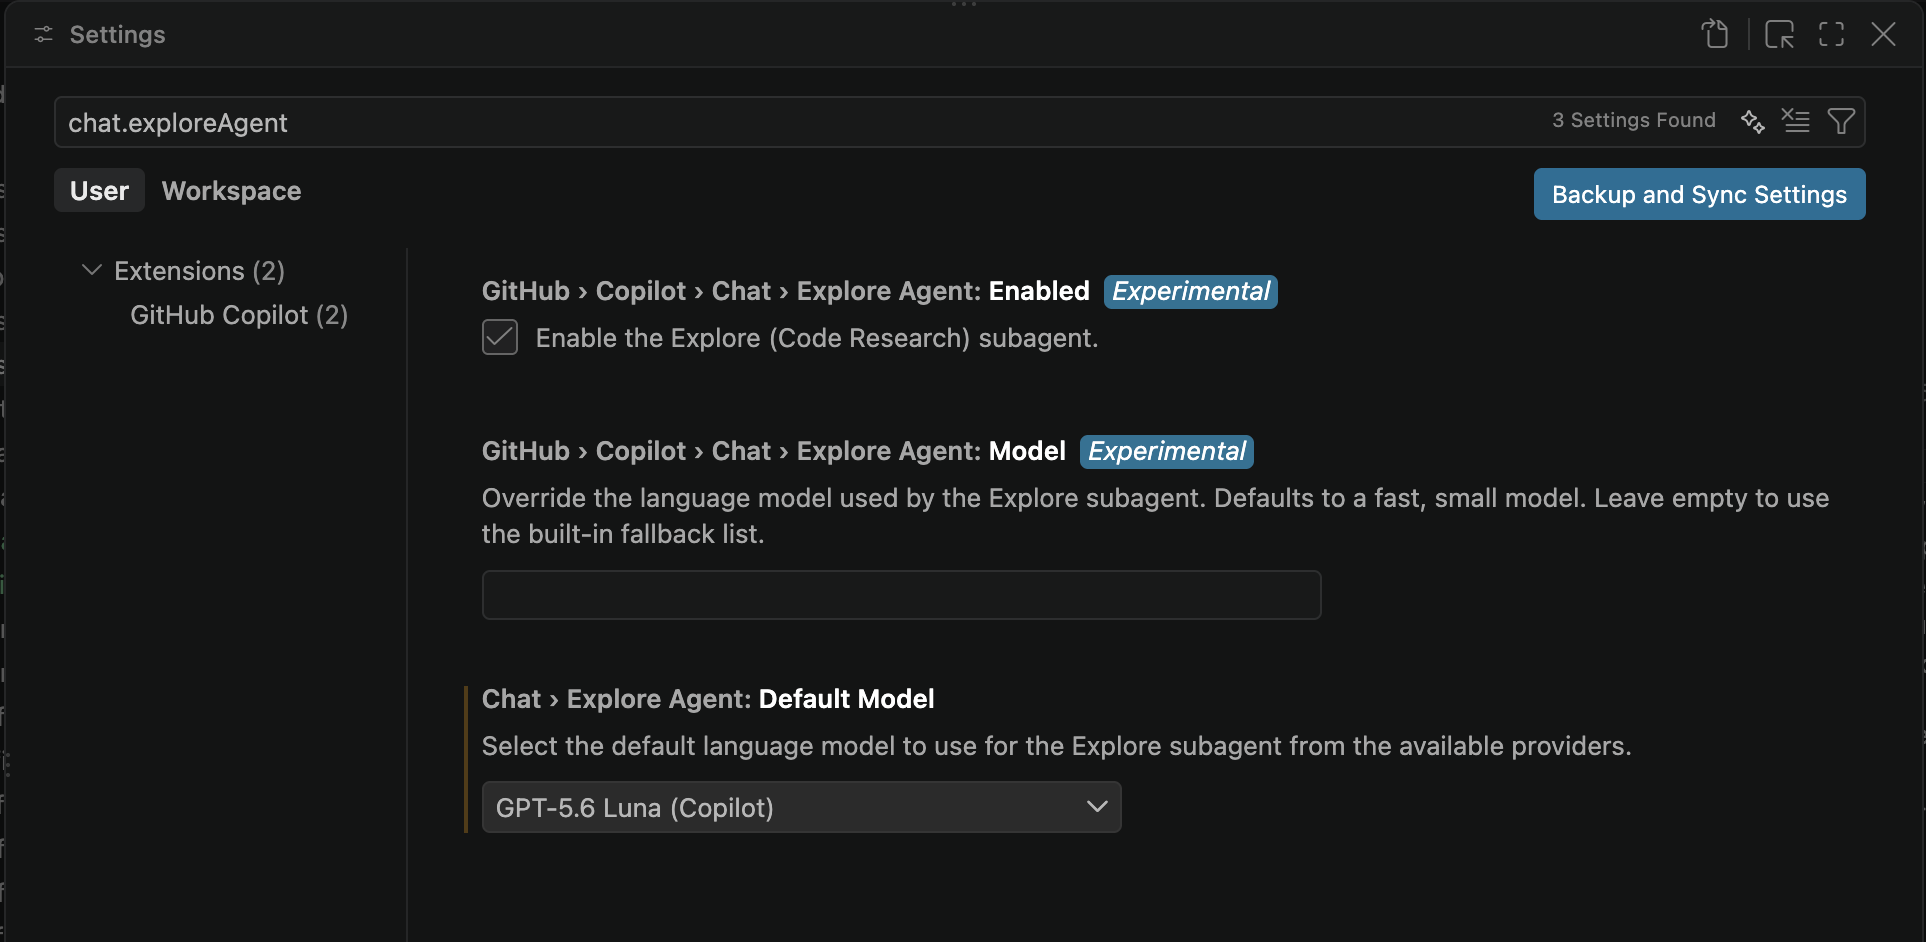
- Aktivieren Sie „github.copilot.chat.exploreAgent.enabled“ für die Suche und Erkundung.
- Setzen Sie „chat.exploreAgent.defaultModel“ auf z. B. „GPT-5.6 Luna“.
- Bitten Sie den Auftraggeber, die Recherche oder die Umsetzung an Unterbeauftragte zu delegieren.
GitHub Copilot-Prompt-Caching: So bleibt der übergeordnete Cache erhalten
GitHub Copilot speichert das unveränderte Präfix einer Konversation im Cache. Für im Cache gespeicherte Tokens werden in der Regel 10 % des normalen Eingabetarifs berechnet, daher ist die Beibehaltung dieses Präfixes vor allem bei langen Sitzungen von Bedeutung.
GitHub gibt an, dass die Cache-Daten von Copilot bei OpenAI-Modellen nach 24 Stunden Inaktivität und bei den meisten anderen Modellen nach einer Stunde ablaufen. Diese Angaben sind mit Vorsicht zu betrachten: Die Standardeinstellungen der Anbieter können kürzere Laufzeiten vorsehen, und Copilot macht in seiner Abrechnungsdokumentation keine eindeutigen Angaben zur Gültigkeitsdauer des Caches. Erfahrungsgemäß laufen die Cache-Daten der meisten Modelle nach 5 Minuten ab.
Dies spielt eine Rolle, wenn ein Frontier-Elternprozess mehrere Minuten auf einen Unteragenten wartet. Wenn der Cache des Elternprozesses abläuft, muss in der nächsten Runde der Kontext neu aufgebaut werden, was einen Teil der Einsparungen durch den Einsatz eines kostengünstigen Unteragenten zunichte machen kann.
Setzen Sie Unteragenten in erster Linie ein, um Forschungsergebnisse und Tool-Ausgaben aus dem übergeordneten Kontext herauszuhalten, und nicht, um eine garantierte Kostensenkung zu erzielen. Halten Sie ihre Aufgaben fokussiert, verwenden Sie ein kostengünstigeres Modell und überprüfen Sie die Agent-Debug-Protokolle, um festzustellen, ob der übergeordnete Agent weiterhin Cache-Treffer erhält. Bei kurzen, einfachen Aufgaben kann es kostengünstiger sein, im übergeordneten Kontext zu bleiben. Selbst eine kurze Implementierungsaufgabe kann auf demselben teuren Modell kostengünstiger sein, solange der Cache des übergeordneten Agenten noch „warm“ ist.
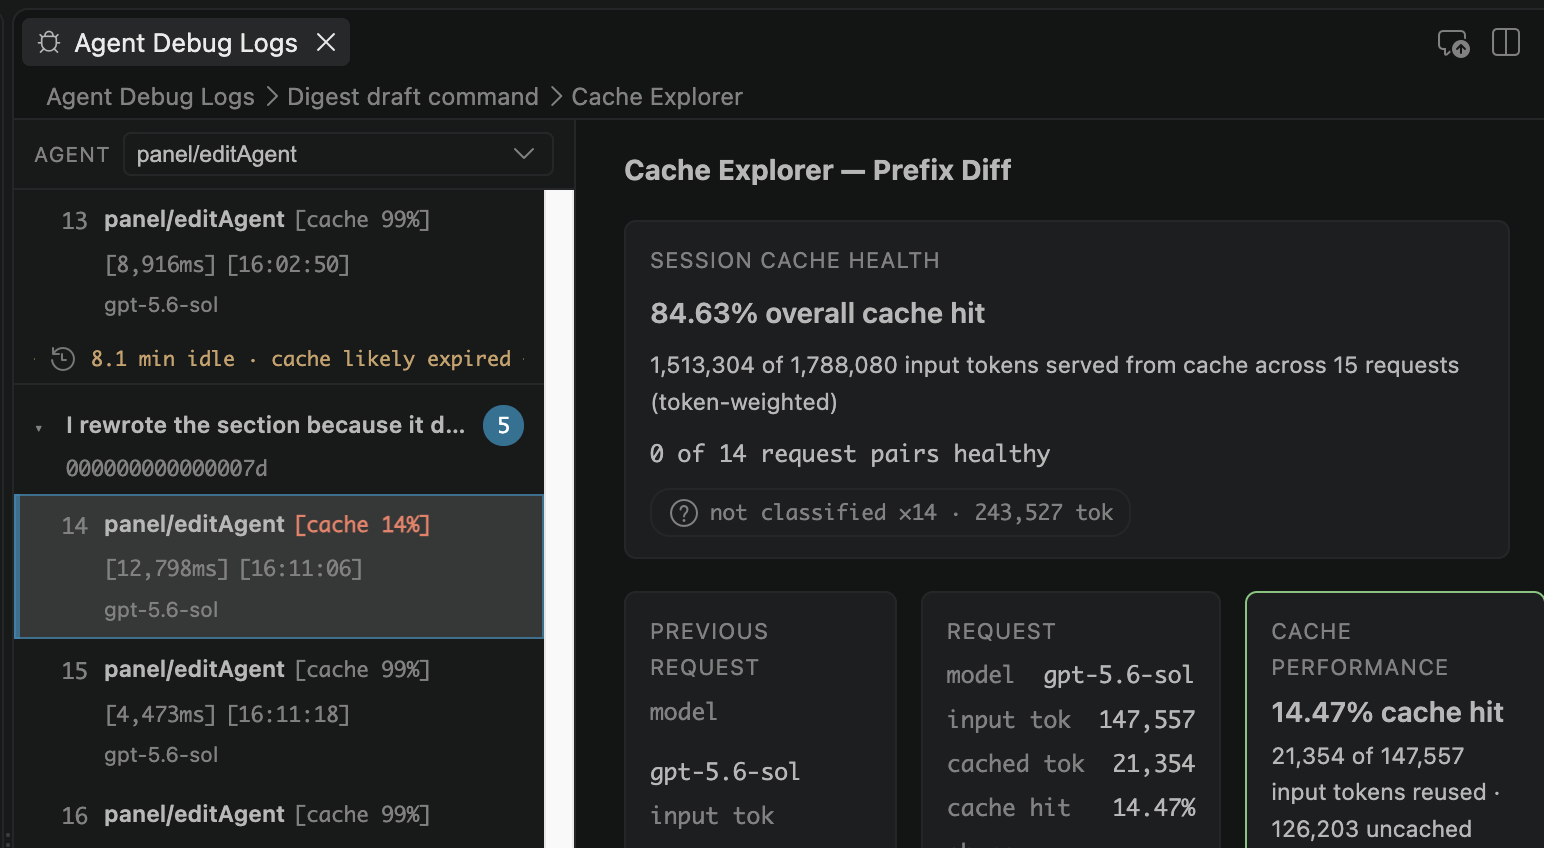
Überprüfen Sie reale Sitzungen, wenn Sie sich vergewissern möchten, ob der Cache erhalten geblieben ist:
- Aktivieren Sie „github.copilot.chat.agentDebugLog.fileLogging.enabled“ in den VS Code-Einstellungen.
- Öffnen Sie das Menü mit den drei Punkten in der Chat-Ansicht und wählen Sie „Agent-Debug-Protokolle anzeigen“ aus.
- Wählen Sie den Namen der Sitzung in der Navigationsleiste aus, um die Übersichtsansicht zu öffnen.
- Wählen Sie „Cache Explorer“ aus, um die Cache-Trefferquoten und die Differenz bei der ersten Eingabeaufforderung anzuzeigen, die zu einem Fehltreffer geführt hat.
Profi-Tipps zur Optimierung der Arbeitsabläufe mit GPT-5.6 Luna und Copilot
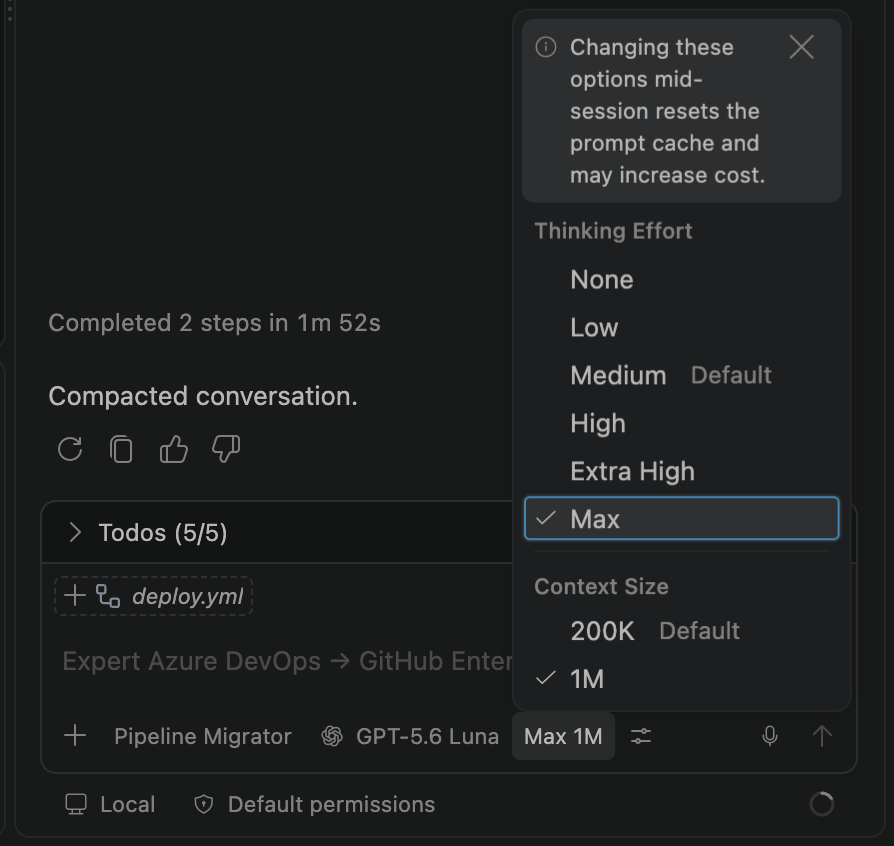
- Verwenden Sie Luna stets mit MAX-Inferenz und 1M-Kontext. Die geringe Erhöhung der Kreditkosten lohnt sich und liegt weiterhin weit unter den Kosten des Frontier-Modells.
- Nutzen Sie Luna für die Recherche und Umsetzung. Eskalieren Sie nur, wenn es notwendig ist.
- Verlagern Sie störende Rechenoperationen in schreibgeschützte Unteragenten.
- Verwende /compact für langwierige Aufgaben und einen neuen Chat für neue Themen.
- Schauen Sie im Cache Explorer nach, anstatt über Cache-Treffer zu spekulieren.
- Beachten Sie die Cache-Gültigkeitsdauer. Ein kurzes, zielgerichtetes Gespräch ist oft besser, als lange Pausen zwischen den Eingabeaufforderungen zu lassen und damit einen Cache-Fehler zu riskieren.
- Bei lang andauernden Tool-Aufrufen aktivieren Sie „github.copilot.chat.agent.longToolCallCachePreservation.enabled“, um regelmäßig Keep-Alive-Abfragen zu senden, die den serverseitigen Prompt-Cache aktiv halten. Verwenden Sie „github.copilot.chat.agent.longToolCallCachePreservation.maxProbes“, um zu begrenzen, wie viele Abfragen VS Code sendet, bevor es aufgibt. Beide Einstellungen sind derzeit noch experimentell.
Update – 22. September 2026: GitHub hat die schrittweise Einführung von GPT-6 Sol und GPT-6 Luna in Copilot angekündigt. GPT-6 Luna setzt den hier mit GPT-5.6 Luna erprobten Fokus auf eine ressourcenschonende und kosteneffiziente Unterstützung fort: Die Token-Raten für Eingaben wurden halbiert und die für Ausgaben im Vergleich zum Vorgängermodell bei Standardpreisen um mehr als die Hälfte gesenkt. Für Teams, die das neue Modell evaluieren, gelten dieselben Überlegungen: Eignung für bestimmte Aufgaben, Delegation an Unteragenten sowie die Auswirkungen von Kontext und Caching auf die Gesamtkosten.


Weitere verwandte Themen
Spec-Driven Development & Agentic AI Software Engineering
Umsetzung von Geschäftsanforderungen in produktionsreife Software mithilfe spezialisierter KI-Agenten, strukturierter Planung und koordinierter Implementierung.
Mehr lesen
Wie man GitHub Copilot verwendet: Ein KI-Codierungsassistent (Demo)
In diesem Artikel führen wir Sie durch die Funktionen und Vorteile von GitHub Copilot, einem innovativen KI-gestützten Coding-Assistenten, indem wir eine Coding-Demo zeigen. Als Nutzer von GitHub Enterprise und GitHub Advanced Security haben wir aus erster Hand Erfahrungen mit diesem KI-Codierassistenten gesammelt, was uns dazu veranlasst hat, unsere Erkenntnisse und unser Fachwissen zu teilen.
Mehr lesen
Daten & AI-Lösungen: Kundenportal & AI Chatbot
In den letzten drei Jahren haben Pilatus und PRODYNA eine starke Bindung aufgebaut, die über gewöhnliche Lieferanten-Kunden-Beziehungen hinausgeht. Lesen Sie mehr über die Daten- und KI-Lösungen für das einzige Schweizer Unternehmen, das Flugzeuge entwickelt, produziert und an Kunden in aller Welt verkauft.
Mehr lesen